ChrysalisInnovation
Vue d’ensemble des technologies

Transformer votre
savoir-faire en
modèle spécialisé.

SLM Factory organise la spécialisation de modèles de langage à partir d’exemples métier. De la préparation des données à la comparaison des candidats, elle permet d’examiner ce que chaque choix apporte à la tâche visée.

Comment naît un modèle spécialisé

Transmettre un savoir-faire. Des exemples associent une entrée à la réponse attendue pour une tâche métier.

Faire apprendre la spécialité. L’entraînement adapte un modèle de départ à ces exemples.

Éprouver ce qui a été appris. Des exemples distincts servent à guider les réglages, puis un test indépendant permet de juger le résultat final.

Du besoin métier
au modèle évalué.

Des exemples réels ou générés. Un calcul local ou sur GPU serverless. Un modèle ciblé ou une campagne de comparaison. La Factory organise ces choix dans un même parcours.

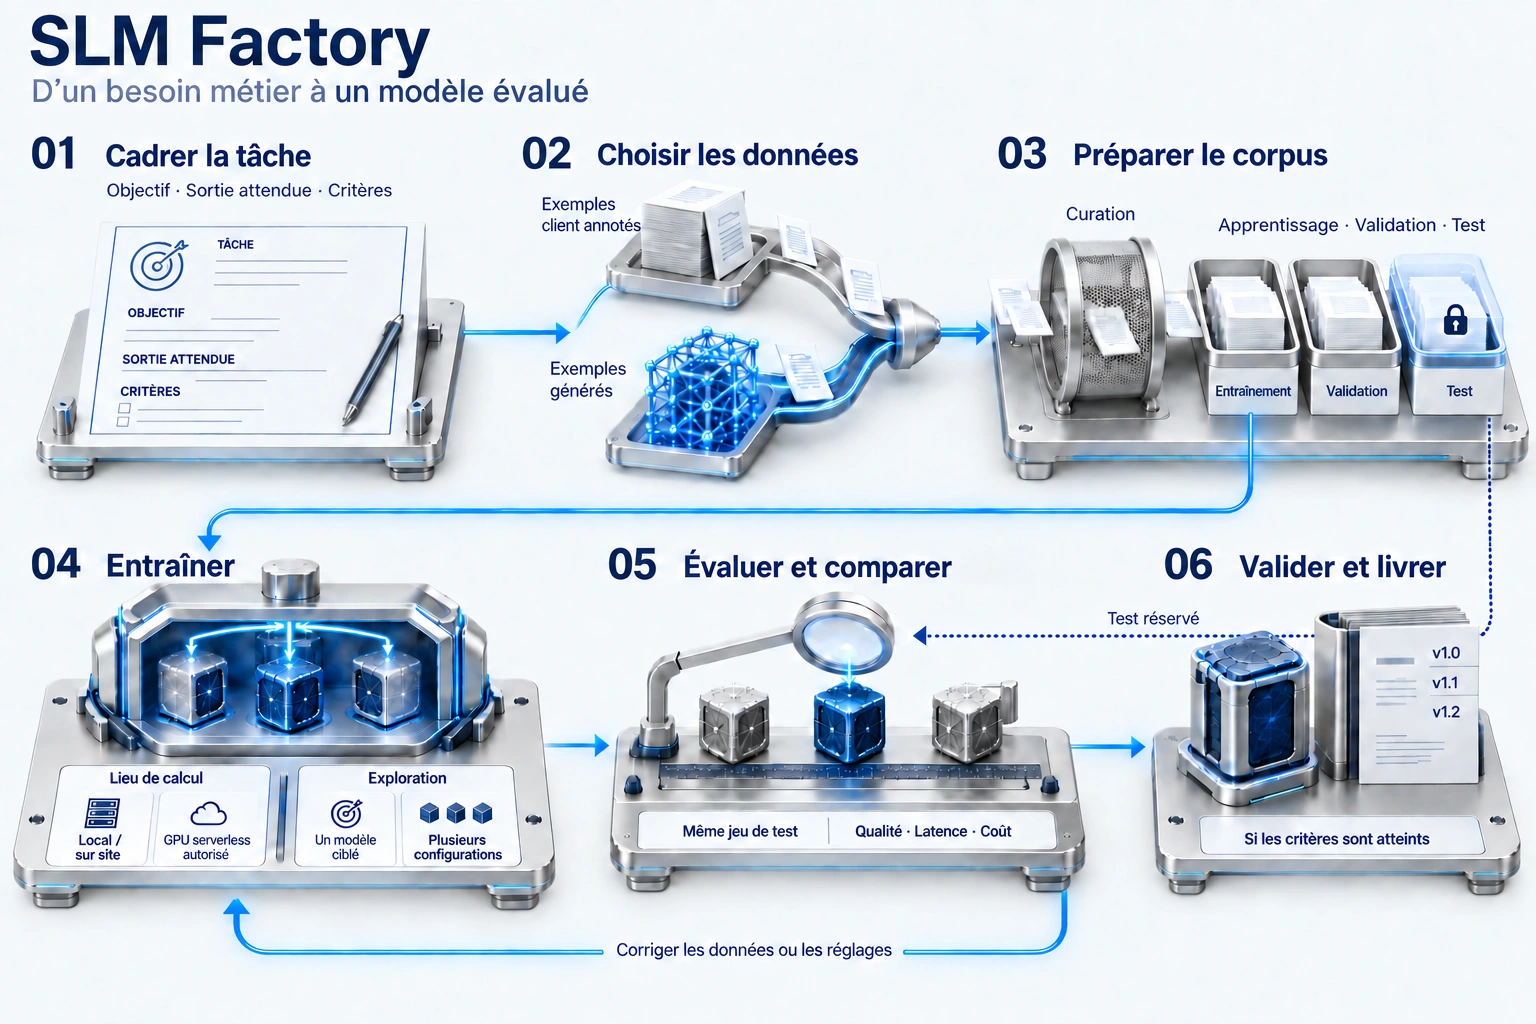
Six étapes : cadrer la tâche, choisir les données, préparer le corpus, entraîner, évaluer et comparer, puis valider et livrer. Les branches distinguent origine des exemples, lieu du calcul et exploration de plusieurs configurations.
Le parcours de spécialisation, de la préparation à la livraison.Agrandir l’infographie ↗
Lire les six étapes du parcours
  1. Cadrer. Définir l’entrée, la sortie attendue et les critères de réussite.
  2. Choisir les données. Partir d’exemples client annotés ou d’exemples générés adaptés à la tâche.
  3. Préparer. Vérifier les exemples, retirer les doublons et séparer apprentissage, validation et test.
  4. Entraîner. Choisir le lieu de calcul et l’étendue de l’exploration : un modèle, plusieurs réglages ou plusieurs candidats.
  5. Évaluer. Comparer les réponses sur des cas réservés, examiner les erreurs et les mesures disponibles.
  6. Livrer. Soumettre la configuration retenue aux contrôles de qualité avant son enregistrement et son export.

Pour garder un test final indépendant, les retours qui guident la boucle d’amélioration doivent venir du jeu de validation. Le « même jeu de test » de l’infographie permet une comparaison finale à cas identiques, une fois les réglages arrêtés. Si ses résultats servent à relancer les réglages, il faut réserver un nouveau jeu indépendant pour le test final.

Apprendre, ajuster,
puis mesurer.

Pourquoi répartir les exemples en trois jeux ? Pour distinguer ce que le modèle apprend, ce qui guide les choix et ce qui permet de juger le résultat.

Pendant l’apprentissage

Apprentissage

Le modèle voit les entrées et les réponses attendues. L’entraînement modifie ses paramètres pour apprendre à reproduire ce savoir-faire.

Exemple : lire les champs d’une facture. Apprendre à retrouver une date, un montant et une référence à partir de factures annotées.

Faire évoluer le modèle
Pendant les essais

Validation

Des exemples distincts permettent de suivre la progression et de guider les réglages, sans servir directement à modifier les paramètres par apprentissage.

Sur d’autres factures. Vérifier si prolonger l’entraînement améliore encore l’extraction ou si le modèle commence à trop s’adapter aux exemples appris.

Choisir comment l’entraîner
Après les choix

Test

Des exemples gardés à l’écart de l’apprentissage et des choix de réglage servent à mesurer le résultat final. Ils donnent une estimation sur des cas nouveaux.

Sur des factures réservées. Mesurer la justesse des champs extraits, le respect du format et les erreurs qui subsistent.

Juger la configuration retenue

Et l’évaluation,
dans tout ça ?

C’est l’opération qui consiste à confronter les réponses du modèle aux réponses attendues. On évalue sur la validation pour guider les essais, puis sur le test pour établir le bilan final. La séparation doit être préservée tout au long des essais pour que le bilan reste fiable.
Un modèle ciblé.
Ou plusieurs pistes
à départager.

La spécialisation pose deux questions indépendantes : quelles configurations comparer, et où les entraîner ?

Explorer ce qui change le résultat.

Partir d’un modèle identifié, faire varier ses réglages ou comparer plusieurs familles et tailles. Les candidats sont examinés sur des cas et des critères communs, avec le modèle de départ comme point de comparaison.

La qualité des réponses, la latence et le coût éclairent le choix selon les mesures disponibles. La configuration retenue doit encore passer les contrôles de livraison.

Choisir où le calcul s’exécute.

En local ou sur site, selon le matériel et le modèle. Sur GPU serverless lorsque la politique du projet autorise l’usage du cloud pour les données concernées.

Certaines études peuvent répartir les entraînements en parallèle, dans une limite définie. Le mode de calcul et les ressources disponibles déterminent cette possibilité.

Des tâches précises.
Des critères concrets.

La bonne question : quelle sortie doit être fiable, et comment le vérifier ? Voici trois exemples de spécialisation.

Extraire des informations

Transformer un document en champs structurés : dates, montants, références.

À évaluerLa justesse des valeurs, le format et le traitement des informations absentes.

Classer des clauses

Affecter une clause à une catégorie juridique définie. Un cas d’école du projet utilise le corpus public LEDGAR.

À évaluerLes catégories bien reconnues et celles que le modèle confond encore.

Repérer des données sensibles

Détecter les informations à masquer dans une chaîne d’anonymisation documentaire.

À évaluerLes données oubliées et les éléments signalés à tort, avant application des règles de remplacement.

Avant de
se lancer.

Faut-il déjà disposer de données annotées ?

Des exemples existants peuvent être importés ; des exemples adaptés à la tâche peuvent aussi être générés. Dans les deux cas, leur pertinence et leur qualité doivent être contrôlées. Des documents bruts demandent une préparation : ils ne constituent pas automatiquement un jeu prêt à entraîner.

Pourquoi ne pas entraîner sur toutes les données ?

Parce qu’une bonne réponse sur un exemple déjà appris ne suffit pas à montrer que le modèle saura traiter un cas nouveau. Il faut réserver des exemples pour guider les choix, puis pour mesurer le résultat. Des doublons ou des variantes trop proches répartis entre les jeux peuvent fausser cette mesure.

Un entraînement terminé signifie-t-il que le modèle est prêt ?

Non. Il faut examiner les réponses, les erreurs et les contraintes d’exécution au regard des critères définis. Une campagne explore les possibilités ; la livraison est une décision distincte, avec ses contrôles.

Une spécialisation à explorer ?

Parlons de
votre sujet.

Contacter Chrysalis